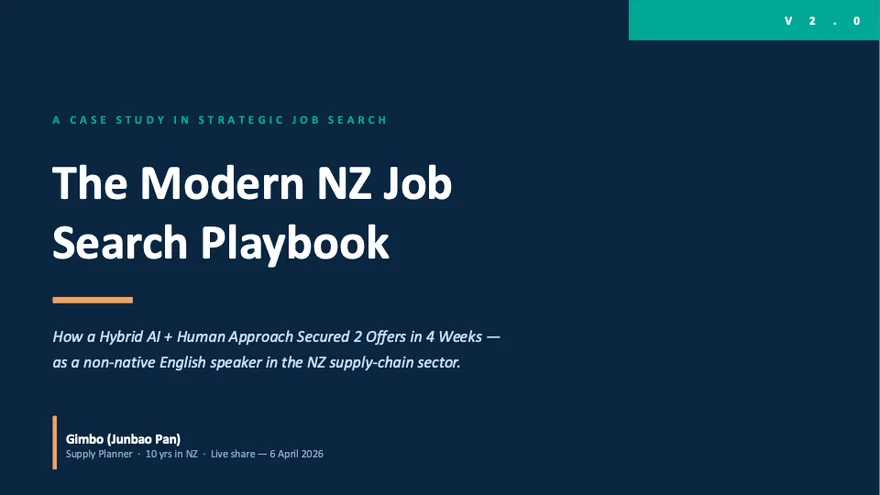
当时的封面 · DECK P12026.04.06
2026 年 4 月 6 日上午十点,我第二次讲同一个求职故事。 开场第一句是:I was in your seat 5 months ago. November 2025—— 我在你们现在的位置上,给了自己一个月,去试一试新西兰的就业市场。
五个月前那场是趁热的复盘,讲的是「刚发生了什么」;这一场是一份 18 页的重制, 讲的是「下次怎么再做一遍」。同样的四周、同样四家本地公司(乳业 / 食品 / 医疗 / 能源)、 10 轮以上面试、两个 offer。核心的难题也没变: 用第二语言,在一场 60 分钟的对话里,证明一辈子攒下的价值。
2025 年 11 月 26 日那场,我讲的是《四周,两个 offer》—— offer 还热着,材料是一篇 11 页的英文复盘长文,结构就是时间顺序:我遇到了什么、我做了什么、结果如何。 那是一手的过程记录,它的价值在于新鲜。
五个月后重讲,我发现新鲜这件事已经过期了,但另一样东西反而长出来了:顺序。 当时是凭直觉一步步走的,现在能把它排成一份别人可以照着跑的配方。 所以 v2.0 不是把旧稿翻译一遍,是把同一段经历从「叙事」重写成「方法」—— 三个支柱,加一个心态。
从趁热的复盘,到一份能交出去的 playbook。
电话初筛 · 技术轮 · 文化轮,四家公司加起来。
两个 offer,都达到或高于我当时的目标。
整份 deck 的骨架只有一个公式:Hybrid = AI speed × human insight。 是乘号,不是加号——任何一边是零,结果就是零。三个支柱按这个公式排: 渠道决定你有多少机会进场,AI 决定你进场前准备得多深,本地教练决定你在场上的分寸感。
三条渠道同时开,按我回头估的权重:专业猎头 50%——一家新西兰本地的供应链专业猎头, 一通 30 分钟的 intake call,一周内三份筛选过的 JD,他们真正的作用是当 Kiwi 招聘规范的翻译器; LinkedIn 30%——Open to Work 打开、关键词收紧(Supply Planner、S&OP), 奥克兰和惠灵顿、发布不超过 7 天的岗位设提醒,看到当天就投,recency beats polish; 内推 20%——在 LinkedIn 上私信了 8 位前同事,两次引荐,其中一次变成正式面试。 私信的回复率 70%,冷启动永远比不上一层温度。
大多数候选人把最大的收益留在了桌上的地方。三步:JD 深挖 prompt、 STAR 故事库、出声的语音模拟面试。下面两节分别讲。
AI 替代不了的那一层:本地文化流利度。我请了一位曾在我面试的几家公司里当过招聘经理的本地教练, 关键轮次前一到两天做一场 90 分钟的 mock。她的作用和 AI 恰好相反——见第 05 节。
v1 的时候,我的做法是「把 CV 和 JD 丢进去,让它给我一份备战计划」——有用,但输出很散。 v2 把它固化成一条带编号、带评分、带产出格式的 prompt。 前置动作是把三份材料放进同一个 project:CV、完整 JD、公司的 About Us 页面。
开头一句先给角色:「你是我的新西兰面试教练。我附上了我的 CV 和这个岗位的 JD。请你:」
第二步是 STAR 故事库。这里有一个我在 v2 才敢下的结论:5 个故事覆盖 80% 的行为题。 五个类别分别是——解决过的复杂问题、和干系人的冲突、一次数据驱动的决策、 一次失败和从中学到的、没有职权时的领导(最后一条最容易被忽略,也最容易加分)。
四段的配比是有讲究的:S 两句话交代处境和风险;T 说清我的具体任务, 说「我」不说「我们」;A 要占 60% 的时长——决策、取舍、影响了谁、用了什么工具; R 只给数字。deck 里我用了一个促销库存救火的示范故事来演示这个配比: 供应商漏了一次周配送,我的任务是在零售商的周二截止前把 fill rate 拉回来, 行动是拉三个月消耗、把缺口拆到两个备用 SKU、谈下一次当天的运费例外, 结果是 fill rate 回到 99.2%、零罚款。
这是 v2 里我加得最狠的一条,也是最多人做不到的一条:打开语音模式,出声回答。 在脑子里过一遍答案,感觉总是很好;一开口,你才发现那个转折句根本接不上。
指令给得很死:「Act as the hiring manager for [role]. Ask one behavioural Q at a time. Wait for my verbal answer.」然后不许照着笔记念。结巴、卡住、重来,那正是这件事的重点。 能录音就录。答完立刻要批评:「Rate my last answer on: clarity, structure, specificity, confidence. Suggest 2 concrete improvements.」拿到两条修正,下一题就用上。 一场五轮,循环是 ask → answer → critique → retry。
每一次模拟都会浮出一个填充词、一个软掉的收尾、一个漏掉的数字——这些东西你在真实面试里也会犯, 区别只在于那一次的代价是一个 offer。
同一个循环还有一个更大的版本,跨越整场求职:面试完当场记笔记 → 24 小时内写 debrief, 列出每道题、我的回答、哪里强哪里弱 → 丢给 AI 找模式(「看看我最近三份 debrief,什么在反复出现?」) → 更新 STAR 库、重写弱的故事、准备下一轮要问对方的问题。 判断这个循环有没有在转,只有一句话:第四场面试不该感觉像第一场。如果像,循环就是断的。
这是整份 deck 里我自己最满意的一句话,因为它一句话解释了为什么两边都不能省。
AI 的盲区很具体:它感觉不到 Kiwi 文化。它不会告诉你, 「I led a team of 12」这句话在惠灵顿的会议室里听起来有点自大。 它只会把这句话写得更漂亮一点。
而教练之所以值五星,是因为她在我面试的几家公司里当过招聘经理—— 她知道那边的人会怎么听我说话。所以整份 deck 的关键洞察,其实不在任何一根支柱上, 而在两根之间:Neither AI alone nor coach alone worked. The magic is in the handoff between the two.
11 月那场我把「你能控制多少」当成一个开放问题抛给听众;4 月这场,我把它写成了两栏清单。
你 100% 能控制的:准备的小时数和重复的次数、STAR 库的质量、
每场面试之后有没有真的复盘、准时出现且状态是热的、24 小时之内的跟进信。
你控制不了的那 50–60%:池子里其他候选人有多强、主观的 culture fit 判断、
对方内部的政治与预算冻结、第三轮突然冒出来的一个内部候选人。
我在这一页下面加了一行小字:信心是可再生资源——但它不会在你把它烧在 控制不了的变量上之后自动长回来。所以「master the inputs, release the outputs」不是鸡汤, 是一种能耗管理:把力气花在会累积的地方。
这仍然是样本量为 1 的经验。三条渠道的 50/30/20 是我回头估的权重,不是统计。 四周两个 offer 里有时机的成分,这一点在 11 月那篇里我已经写过。 还有一层更微妙的:这份 v2.0 是五个月后重制的,记忆本身已经被整理过一次—— 它比当时更整齐,也就一定比当时更失真。能被复制的从来不是结果,是流程。
第一次讲的时候,我讲的是「我做了什么」;第二次讲的时候,我讲的是「换成你,该怎么做」。 这中间的差值,就是把一段经历变成一份资产的全部工作量: 把当时的直觉找出来、给它命名、排出顺序、写成别人能照着跑的步骤。
七条 takeaway 里我自己最信的是第一条——Hybrid > purely AI or purely human。 但更底层的一条不在 deck 上:一段经历如果只被经历过,它会跟着记忆一起褪色; 被认真整理过一次,它才开始产生利息。
五个月前那场分享的最后一页,我写的是「你的过程,才是你最大的资产」。 当时那更像一句自我安慰。这一场,是我把它兑现成 18 页的方式—— 也是我第一次相信,下一次找工作,我不用再从零开始。
本文是「HOW TO ___ · 读书会分享」系列的第 7 场(共 11 场),分享发生于 2026 年 4 月 6 日,内容整理自当时真实的分享材料。全系列按最初分享的时间排在 Ideas 时间线上。